
Quando sentiamo parlare di intelligenza artificiale, oggi pensiamo quasi subito a una finestra in cui scrivere una domanda e ricevere una risposta. È comprensibile: ChatGPT, Claude, Gemini e Copilot hanno reso visibile una tecnologia che, fino a poco tempo fa, per molte persone sembrava lontana o riservata agli specialisti.
La chat ha avuto un merito enorme: ci ha permesso di usare il linguaggio di tutti i giorni. Non abbiamo dovuto imparare comandi particolari; è bastato chiedere un riassunto, una spiegazione, una bozza di e-mail o un aiuto per mettere ordine nelle idee.
Proprio questa semplicità, però, può creare un equivoco. Ciò che vediamo sullo schermo è soprattutto un’interfaccia, cioè il punto attraverso cui entriamo in contatto con un sistema molto più complesso. È un po’ come il cruscotto di un’automobile: ci mostra velocità, direzione e carburante, ma sotto il cofano lavorano insieme motore, batteria, sensori, freni e molti altri componenti.
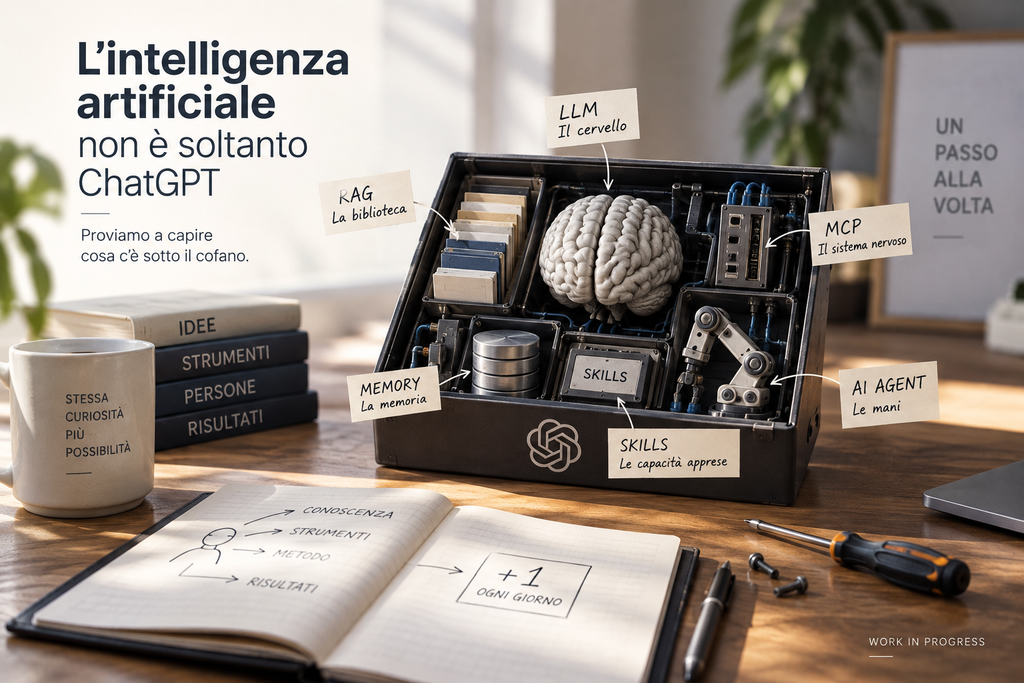
Per capire che cosa succede sotto il cofano dell’intelligenza artificiale, possiamo affiancare a questa immagine un’altra metafora ancora più semplice: quella del corpo umano. Un sistema moderno può avere un cervello per comprendere, una biblioteca da consultare, un sistema nervoso per comunicare con l’esterno, capacità apprese, memoria e mani con cui agire.
Seguendo questa immagine, sigle come LLM, RAG e MCP diventano meno misteriose. Non serve trasformarsi in informatici: basta capire quale ruolo svolge ciascun elemento e, soprattutto, che cosa cambia quando tutti iniziano a collaborare.
Il cervello: l’LLM
Al centro di strumenti come ChatGPT troviamo un LLM, sigla di Large Language Model, cioè “grande modello linguistico”. “Grande” richiama sia la quantità di testi usati durante l’addestramento sia la complessità del modello; “linguistico” indica che il suo terreno principale è il linguaggio.
In modo molto semplificato, durante l’addestramento il modello incontra enormi quantità di testo e impara a riconoscere regolarità: quali parole tendono a comparire insieme, come si costruisce una spiegazione, come cambia il tono tra una lettera formale e un messaggio informale, quali concetti sono spesso collegati. Non memorizza semplicemente un archivio di domande con la relativa risposta.
Quando gli scriviamo, usa ciò che ha appreso per generare una continuazione coerente, parola dopo parola. Se gli chiediamo di spiegare la fotosintesi a un bambino, non apre necessariamente una scheda già pronta: costruisce una risposta adatta alla richiesta, al contesto e allo stile indicato.
È proprio questa capacità generativa a renderlo flessibile. Lo stesso modello può riassumere un contratto, proporre una ricetta con ciò che abbiamo in frigorifero o trasformare appunti confusi in un testo ordinato. Ma la fluidità non garantisce la verità.
Un LLM può produrre una frase molto plausibile e tuttavia sbagliata. Nel settore si usa il termine “allucinazione” per indicare un contenuto inventato o non sostenuto dai fatti, presentato magari con grande sicurezza. Può accadere con una data, il titolo di un libro, una norma inesistente o una fonte che sembra credibile ma non esiste. OpenAI descrive le allucinazioni proprio come affermazioni plausibili ma false e ricorda che il problema non è stato eliminato neppure nei modelli più capaci.
Possiamo immaginare un collega molto eloquente che abbia letto moltissimo, ma che, quando non ricorda un dettaglio, talvolta provi comunque a completare il discorso. Il risultato può suonare bene senza essere corretto. Per questo un LLM è uno strumento utile per comprendere, elaborare e scrivere, ma non deve essere considerato automaticamente una fonte dei fatti. Quando l’esattezza conta, occorrono verifiche e fonti affidabili.
La biblioteca: il RAG
Immaginiamo di chiedere a una persona molto preparata: «Qual è la procedura della mia azienda per approvare una trasferta?». Potrebbe conoscere bene il funzionamento generale delle trasferte, ma non le regole della nostra organizzazione. Prima di rispondere dovrebbe dire: «Aspetta, controllo il manuale».
Il RAG, cioè Retrieval Augmented Generation, introduce proprio questa possibilità. Il termine indica una generazione “arricchita” dal recupero di informazioni. Il lavoro originale che ha reso noto questo approccio descrive sistemi che combinano un modello generativo con una memoria esterna consultabile.
Il percorso, osservato dall’esterno, è abbastanza intuitivo. Noi poniamo la domanda; il sistema cerca tra i documenti disponibili; individua i passaggi più pertinenti; li porta nel contesto del modello; infine l’LLM usa quel materiale per costruire la risposta.
Nel caso della trasferta, la ricerca potrebbe recuperare la politica aziendale, il modulo corretto e il paragrafo con i limiti di spesa. Il modello non risponderebbe più soltanto sulla base di ciò che ha appreso durante l’addestramento, ma avrebbe davanti le regole effettivamente disponibili in quel momento.
Questo non significa necessariamente insegnare in modo permanente qualcosa al modello. È più simile a consegnargli, per quella richiesta, le pagine giuste da leggere. Se domani il manuale viene aggiornato, il sistema potrà recuperare la nuova versione senza dover necessariamente riaddestrare l’intero LLM.
Lo stesso principio può essere utile fuori dall’azienda. Pensiamo a un tecnico che chiede come interpretare un codice di errore di una caldaia: il sistema può cercare nel manuale del modello corretto, recuperare la procedura e preparare una spiegazione. Oppure può consultare una raccolta normativa o un catalogo prodotti, purché le fonti siano disponibili e l’accesso sia consentito.
La biblioteca, però, non rende il cervello infallibile. Se contiene documenti vecchi, incompleti o contraddittori, la risposta ne risentirà. Anche il sistema di ricerca può scegliere un passaggio poco pertinente, e il modello può interpretarlo male. Il RAG può rendere le risposte più ancorate alle fonti e più aggiornabili, ma la qualità dipende da ciò che viene cercato, recuperato e poi utilizzato.
Il sistema nervoso: MCP
A questo punto abbiamo un cervello capace di lavorare con il linguaggio e una biblioteca da consultare. Manca però un modo ordinato per mettere il sistema in comunicazione con applicazioni, database, calendari, archivi e strumenti operativi.
È qui che incontriamo MCP, cioè Model Context Protocol. Anthropic lo ha presentato nel novembre 2024 come uno standard aperto per collegare gli assistenti di intelligenza artificiale ai sistemi in cui vivono dati e strumenti. Il problema di partenza è semplice: senza uno standard, ogni collegamento rischia di dover essere progettato su misura.
Pensiamo alle prese elettriche o a una porta USB-C. Se ogni produttore inventasse una presa completamente diversa per ogni dispositivo, collegare computer, monitor e telefoni sarebbe molto più complicato. Uno standard non decide che cosa farà il dispositivo, ma stabilisce un modo condiviso per metterlo in comunicazione con gli altri.
MCP prova a svolgere un ruolo simile per le applicazioni di intelligenza artificiale. Può offrire un linguaggio comune attraverso cui un sistema scopre quali informazioni e strumenti sono disponibili e come richiederli. La documentazione ufficiale usa proprio il paragone con una porta USB-C per spiegare questa funzione.
La metafora principale resta però quella del sistema nervoso. Il cervello non vede direttamente il calendario, non apre da solo un database e non modifica spontaneamente un documento. Ha bisogno di collegamenti che portino informazioni verso di lui e, quando previsto, trasmettano richieste di azione verso gli strumenti.
Questo non significa che MCP sia l’unico modo per integrare l’intelligenza artificiale con il mondo esterno. Esistono API, connettori, funzioni e altre soluzioni. MCP è uno standard possibile, oggi importante, che cerca di ridurre la frammentazione e facilitare collegamenti riutilizzabili.
Naturalmente, collegare non significa autorizzare tutto. La specifica MCP richiama esplicitamente consenso, controllo dell’utente, protezione dei dati e comprensione delle azioni richieste. Un buon sistema nervoso non deve soltanto trasmettere segnali: deve farlo entro confini chiari.
Le capacità apprese: le Skills
Conoscere un argomento e sapere come svolgere un compito non sono la stessa cosa. Possiamo aver letto molto di cucina e non saper organizzare bene una cena per dieci persone; allo stesso modo, un sistema può conoscere Excel in generale senza sapere quale procedura seguire per analizzare il nostro specifico rapporto mensile.
Con il termine Skills si indicano spesso capacità operative organizzate: istruzioni, criteri, esempi e risorse che aiutano il sistema a svolgere una determinata attività in modo più coerente. Il termine non è usato nello stesso modo da tutte le piattaforme; quindi, è meglio concentrarsi sull’idea anziché sull’etichetta.
Supponiamo di consegnare un foglio di calcolo e chiedere genericamente: «Analizza questi dati». Il risultato potrebbe essere utile, ma anche molto variabile. Una Skill ben definita potrebbe invece indicare di controllare prima le intestazioni, segnalare i valori mancanti, distinguere dati effettivi e previsioni, calcolare soltanto gli indicatori concordati e presentare le anomalie in una tabella finale.
Prendiamo poi un processo aziendale, come la preparazione di una richiesta di acquisto. Non basta conoscere in astratto che cosa sia un acquisto: occorre verificare il centro di costo, raccogliere i preventivi richiesti, controllare le soglie di approvazione e preparare la documentazione nel formato previsto. La capacità sta nella sequenza e nei controlli, non soltanto nelle nozioni.
Una procedura riutilizzabile non rende perfetto il sistema, ma riduce l’improvvisazione. Invece di affidarsi ogni volta a un prompt generico, gli offre una strada già tracciata, con passaggi e criteri che possono essere verificati e migliorati nel tempo.
Nella metafora del corpo, le Skills assomigliano alla memoria muscolare. Dopo aver imparato un gesto non ripartiamo ogni volta da zero: sappiamo come muoverci, pur continuando a prestare attenzione alla situazione concreta.
Le mani: gli agenti
Arriviamo così agli agenti, la parte che forse mostra meglio il cambiamento in corso. In una normale interazione domanda-risposta chiediamo qualcosa e riceviamo un testo. Un agente, invece, può essere progettato per perseguire un obiettivo attraverso più passaggi e con gli strumenti che gli sono stati concessi.
La logica può essere immaginata come un piccolo ciclo. Prima comprende l’obiettivo; poi prepara un piano; sceglie lo strumento adatto; compie un’azione; controlla il risultato; infine decide se il lavoro è terminato o se serve un altro passo. Non è una formula rigida, ma un modo utile per distinguere una risposta isolata da un’attività coordinata.
Confrontiamo due richieste. La prima è: «Consigliami un viaggio di tre giorni a Parigi». Un chatbot può proporre quartieri, musei e ristoranti sulla base delle informazioni disponibili. La risposta può essere ottima, ma rimane soprattutto un consiglio.
La seconda è più impegnativa: «Organizzami un viaggio di tre giorni a Parigi dal 15 al 17 novembre, verificando i miei impegni, confrontando voli e hotel entro un certo budget e proponendomi una soluzione». Qui non basta scrivere un itinerario. Bisogna controllare il calendario, cercare alternative, confrontare prezzi e orari, rispettare vincoli e presentare una proposta coerente.
Per diventare davvero operativo, il sistema deve avere accesso al calendario e ai servizi necessari; deve sapere quali dati può leggere; deve disporre delle autorizzazioni dell’utente; deve conoscere le azioni consentite e quelle vietate. Soprattutto, dovrebbe chiedere conferma prima di compiere operazioni importanti, come effettuare una prenotazione o sostenere una spesa.
Potrebbe quindi scoprire che il venerdì mattina esiste già una riunione, escludere un volo incompatibile, selezionare tre hotel entro il budget e preparare una proposta. A quel punto potrebbe fermarsi e chiedere: «Vuoi che proceda con questa soluzione?». La pausa non è un limite inutile: è parte del controllo.
Lo stesso principio vale nel lavoro. Un agente potrebbe ricevere l’obiettivo di preparare un rapporto settimanale, recuperare i dati autorizzati, applicare una procedura, creare una bozza e segnalare ciò che manca. Potrebbe anche aggiornare un documento, ma soltanto se lo strumento e le regole glielo consentono.
Non c’è nulla di fantascientifico o di indipendente in questo comportamento. L’agente non sviluppa una volontà propria: opera dentro un perimetro definito da obiettivi, strumenti, istruzioni, autorizzazioni e limiti. Nei processi importanti, la supervisione umana resta essenziale; Microsoft, per esempio, documenta flussi in cui fasi automatiche e approvazioni umane vengono combinate proprio per mantenere le persone in controllo delle decisioni critiche.
Il chatbot risponde a una domanda. L’agente prova a portare avanti un obiettivo. La differenza non sta nella personalità del sistema, ma nella possibilità di coordinare ragionamento e azioni.
La memoria
C’è poi la memoria, una parola semplice che nei sistemi di intelligenza artificiale può indicare cose diverse. La forma più immediata è il contesto della conversazione: il sistema tiene conto di ciò che abbiamo scritto pochi messaggi prima e riesce a comprendere riferimenti come «accorcialo» o «usa lo stesso tono».
Questo contesto, però, non coincide necessariamente con una memoria persistente. Una memoria più duratura può significare recuperare una preferenza conservata, consultare lo storico di un progetto, ricordare il formato con cui prepariamo abitualmente un rapporto oppure ottenere informazioni da un sistema esterno autorizzato.
Immaginiamo di chiedere ogni settimana la preparazione dello stesso resoconto. Senza memoria dovremmo ripetere destinatari, struttura, periodo e criteri. Con una memoria progettata correttamente, il sistema potrebbe recuperare queste preferenze e chiederci soltanto ciò che è cambiato.
La memoria rende quindi l’esperienza più continua: evita di ripartire ogni volta da zero e aiuta a interpretare una richiesta alla luce di ciò che è accaduto prima. Ma proprio per questo richiede attenzione. Non tutto deve essere ricordato, non tutto deve esserlo per sempre e non ogni informazione deve essere disponibile in ogni situazione.
Privacy, consenso e autorizzazioni diventano parte della progettazione. L’utente dovrebbe poter capire quali informazioni vengono conservate o recuperate e, quando possibile, controllarle. Una memoria utile non è quella che accumula tutto, ma quella che conserva o ritrova ciò che serve entro limiti comprensibili.
Quando tutto lavora insieme
Finora abbiamo osservato i singoli elementi. Proviamo ora a immaginare una richiesta molto comune: «Preparami la riunione di domani sul progetto X».
L’LLM, il cervello, comprende che non stiamo chiedendo una definizione del progetto, ma del materiale utile per partecipare a un incontro. Il contesto della conversazione e la memoria possono aiutare a riconoscere quale progetto intendiamo, chi partecipa e quale formato preferiamo.
Il RAG entra nella biblioteca e recupera gli ultimi verbali, il piano di progetto, le decisioni aperte e i documenti pertinenti. Non prende necessariamente tutto: cerca ciò che sembra più rilevante per la riunione.
MCP o altri collegamenti permettono al sistema, se autorizzato, di consultare calendario, archivio documentale e strumenti di lavoro. Una Skill stabilisce come preparare un buon meeting brief: obiettivo, partecipanti, decisioni precedenti, punti aperti, rischi e domande da affrontare.
L’agente coordina i passaggi. Può verificare l’orario, raccogliere le informazioni, applicare la struttura prevista, creare una bozza e controllare se mancano dati essenziali. Se è consentito, può anche proporre di allegare il documento all’invito; prima di modificarlo o inviarlo, però, può chiedere conferma.
Il risultato non è soltanto una risposta in chat. È un documento pronto da rivedere, accompagnato magari da un elenco di questioni aperte e dalle azioni che richiedono la nostra decisione. A questo punto il corpo artificiale è completo: il cervello comprende, la memoria dà continuità, la biblioteca fornisce i fatti, il sistema nervoso crea i collegamenti, le capacità apprese indicano come lavorare e le mani coordinano l’esecuzione.
Più capacità non significa infallibilità
Mettere insieme tutti questi elementi non elimina gli errori. Il sistema può interpretare male l’obiettivo, recuperare un documento incompleto, usare una fonte superata, scegliere lo strumento sbagliato o proporre un’azione che l’utente non desidera.
Possono inoltre emergere problemi di autorizzazione: il sistema potrebbe non avere accesso a un file necessario oppure, al contrario, essere collegato a dati che non dovrebbero entrare in quella specifica attività. Per questo servono permessi proporzionati, controlli e registrazioni comprensibili di ciò che è stato fatto.
La supervisione umana non deve essere vista come una sconfitta dell’automazione. È il modo con cui assegniamo responsabilità e manteniamo il controllo, soprattutto quando un’azione è difficile da annullare, coinvolge altre persone o produce conseguenze economiche.
L’atteggiamento più utile è quindi equilibrato. Un sistema collegato e capace di agire può far risparmiare tempo e ridurre lavoro ripetitivo, ma resta uno strumento da progettare, verificare e governare. Più mani richiedono anche più attenzione a ciò che quelle mani possono toccare.
Il vero cambiamento
Quando valutiamo un’intelligenza artificiale, siamo abituati a chiederci se abbia risposto bene, se abbia commesso errori o se sia migliore di un altro modello. Sono domande importanti e continueranno a esserlo, ma raccontano soltanto una parte della storia.
La domanda più interessante sta diventando: che cosa può fare questo sistema usando tutto ciò che ha a disposizione? Un modello molto capace ma isolato resta confinato alla conversazione. Un sistema meno appariscente, ma collegato alle fonti corrette, dotato di procedure chiare e governato da autorizzazioni adeguate, può risultare molto più utile in un’attività reale.
La trasformazione attuale non consiste soltanto nel produrre risposte sempre migliori. Consiste nel combinare ragionamento, informazioni aggiornate, memoria, strumenti e azioni. È il passaggio da una singola capacità a un insieme coordinato di capacità.
Stiamo quindi passando da strumenti ai quali chiediamo «Che cosa ne pensi?» a sistemi con cui possiamo affrontare un problema dicendo: «Questo è il risultato che devo ottenere. Vediamo insieme come arrivarci.»
Questo “insieme” resta importante. Non significa consegnare ogni decisione alla macchina, ma distribuire il lavoro in modo consapevole: lasciare al sistema ricerca, organizzazione e attività ripetitive, mantenendo alle persone obiettivi, giudizio, conferme e responsabilità.
La metafora del corpo umano ci lascia così un’idea semplice. Un buon cervello rende possibili molte cose, ma la sua utilità dipende anche da ciò che può ricordare, consultare, percepire e fare. Il cervello è fondamentale, ma anche per l’intelligenza artificiale il cervello da solo non basta.
E forse vale anche per noi
Ripensando a questo percorso, mi sembra che la metafora possa suggerire qualcosa anche al di fuori della tecnologia. Un sistema di intelligenza artificiale diventa più capace aggiungendo memoria, strumenti, collegamenti, procedure e nuove capacità. Non cambia tutto in un solo momento: cresce perché, un elemento dopo l’altro, può comprendere meglio il contesto e agire in modo più consapevole.
Forse anche per noi migliorare non significa necessariamente trasformarci completamente. Può voler dire capire oggi qualcosa che ieri non riuscivamo a vedere, correggere un comportamento, imparare una capacità o rendere appena migliore il nostro modo di agire. Un piccolo passo, un elemento in più: quel +1 al giorno che racconta bene l’idea di essere sempre un Work in Progress.
Non è una risposta né una formula. È piuttosto una domanda da lasciare aperta, come ponte verso il prossimo capitolo: quanto può cambiare una persona se smette di cercare il grande salto e comincia ad aggiungere, ogni giorno, un solo pezzo?
Per approfondire
- OpenAI, Why language models hallucinate.
- Patrick Lewis e altri, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020.
- Anthropic, Introducing the Model Context Protocol.
- Model Context Protocol, What is the Model Context Protocol (MCP)? e specifica ufficiale.
- Microsoft Learn, Multistage and AI approvals in agent flows.